资讯
Tavus 发布 Griffin:一半的视频通话参与者没认出对面是 AI
美国 AI 公司 Tavus 于 10 月 1 日发布实时视频模型 Griffin,自称首个 "Human Interaction Model"。官方实验里,54 名参与者中 26 人把它当成了真人。目前只向受信任的测试者开放研究预览。
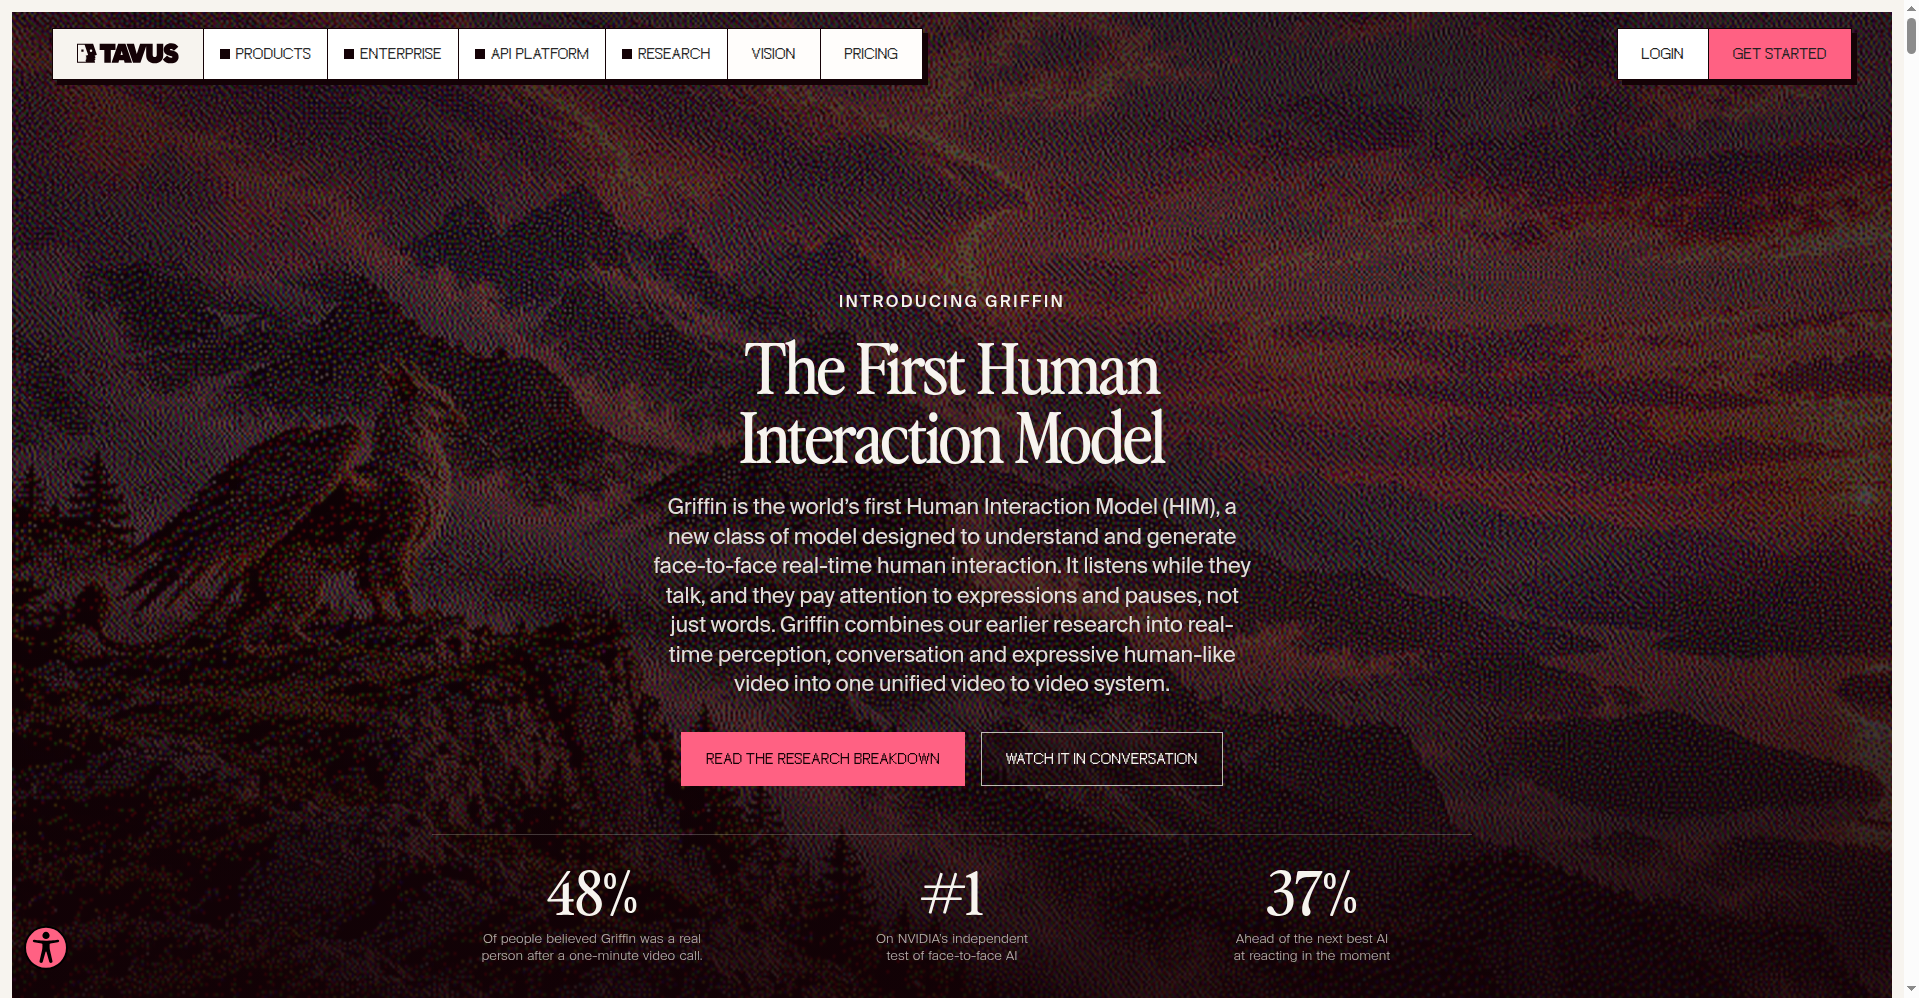
10 月 1 日,美国 AI 公司 Tavus 发布了实时视频模型 Griffin。它把自己称为第一个 “Human Interaction Model”(HIM,人类交互模型):一分钟的视频通话里,48% 的参与者以为对面是个真人。
48% 是怎么测出来的
这组数字来自 Tavus 自己的盲测实验。54 名参与者分别与 Griffin-Lite 通了一分钟视频电话。通话前他们被告知的版本是:对面是另一个参与者。
通完之后问:你觉得刚才和你说话的是真人吗?26 人回答是,占 48%。对比之下,Tavus 上一代数字人系统(Phoenix-4.5 加 Sparrow-2 加 Raven-1)在 41 人里只骗过 1 个人,比例是 2.4%。
Tavus CEO Hassaan Raza 和研究负责人 Ioannis Patras 联名在官方博客里写了这次发布。这个实验的细节他们没公开招募渠道,也没有请第三方来做评估。样本只有 54 人,结论的份量要打些折扣。但即便如此,从 2.4% 到 48% 的跨度,说明新系统在“感觉像人”这件事上有实质进步。
Griffin 和以前的数字人有什么不同
以前的数字人是流水线:语音识别、语言模型、语音合成、面部动画,一个接一个跑。结果是说完一句话才开始处理回复,中间出现尴尬的停顿。
Griffin 把这几个环节做进了一个模型里。视频到视频,全双工:它说话的时候眼睛还在看,耳朵还在听。打断它,它立刻停;你停顿,它能判断你是犹豫还是说完了,决定是接话还是等。它会在你说话的间隙发出 “mm-hm” 这样的回应音,点头、歪头、手势都跟着对话节奏走。
Tavus 举了个例子:Griffin 能一边看着你拧魔方一边教,一边给出提示。换句话说,模型看的是画面,不只是 transcript。
技术指标
按 Tavus 公布的数据:输出 720p、25fps,音画延迟平均 0.43 秒,跑在 NVIDIA H100 上。生成只需要一张照片和约 10 秒的音频,就能做出一个数字分身。
NVIDIA 的 VideoFDB 基准(面向全双工音视频对话的评测)里,Griffin 在生成赛道拿了 3.83 分,人类基准是 3.92 分,排第二的系统是 2.80 分。感知赛道 3.73 分,人类是 4.20 分。不过它的中位响应延迟是 2232 毫秒,比开源的 MiniCPM-o 慢。
为什么先不让你用
Griffin-Lite 目前只给了少数受信任的测试者做研究预览,没有公开 API,没有定价。Tavus 的说法是:安全机制就绪之前不向公众开放。
原因很直接。48% 的欺骗率意味着“视频通话能验证对方是真人”这个假设已经不成立了。去年香港某公司就出过 AI 全员冒充的视频会议诈骗案,一次损失 2500 万美元。工具门槛还在往下降:一张照片加 10 秒音频,就够做一个实时互动的数字分身。
Tavus 说他们正在做披露机制:对面是 AI 这件事,系统要主动说出来。什么时候做好,什么时候再开放。
眼见为实的时代结束了
Griffin 的意义不在于又一个更逼真的数字人。它的出现把一个长期存在的问题推到了台前:当 AI 能在视频通话里听、看、说、反应,连打断和停顿都处理得像人一样,传统信任手段(看一眼、听两句)就失效了。
Tavus 发布了一支短片,主角是运行在 Griffin 上的数字人 Vanessa。它说这是一种 “human computing”:机器隐身,你跟朋友聊天一样跟它说话。这句话听起来温和,但同一个能力装到诈骗团伙手里就是另一回事。
接下来要看的是两件事。第一,Tavus 的安全披露机制做成什么样。第二,视频通话的身份验证会不会出现新的标准做法。这两个答案没出来之前,Griffin 只会停在研究预览阶段。