资讯
微软发布 Decision-1:不写文本、只做决策的打分模型
10 月 9 日,微软发布 Decision-1,一款做结构化决策的打分模型。它不写文本,只从给定选项里挑最优解并给出概率分数。基础模型是阿里的 Qwen3.5-9B,输入每百万 token 0.042 美元,输出免费。上个月刚被创业公司带火的决策模型赛道,现在微软、OpenAI、Cloudflare 全进来了。
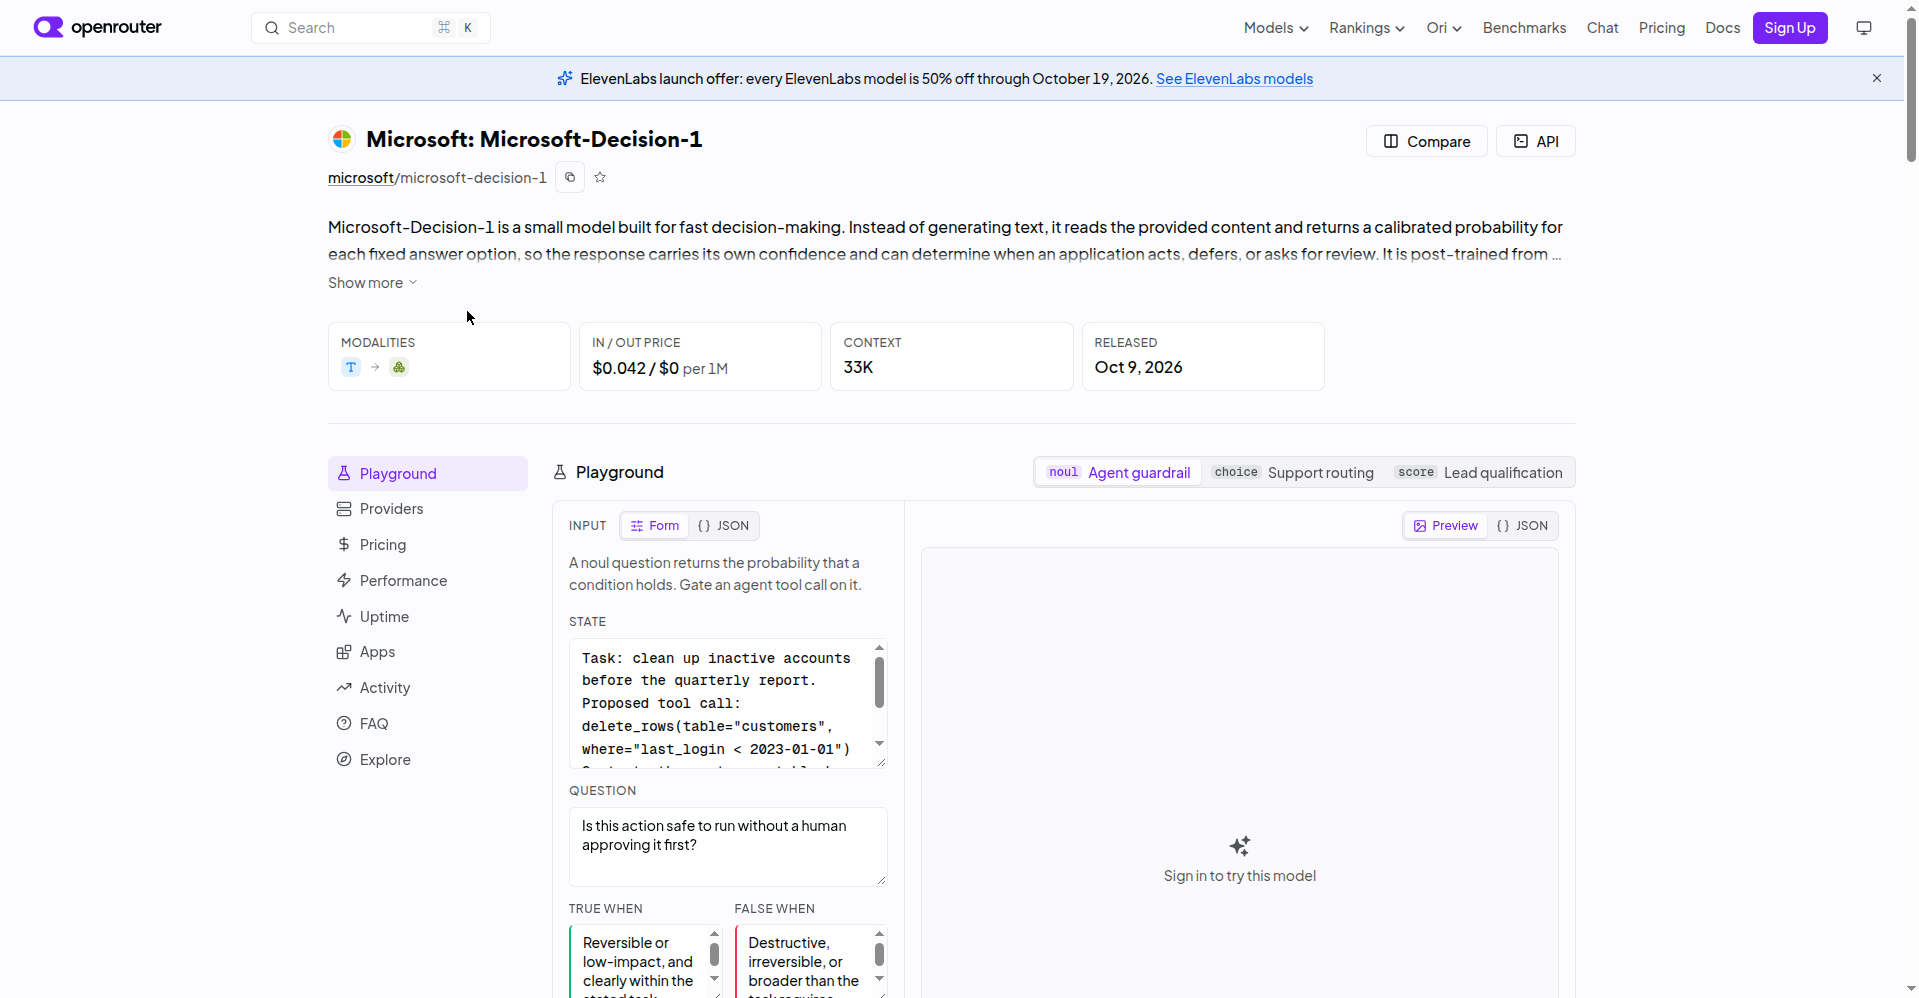
10 月 9 日,微软 CEO 萨提亚·纳德拉在 X 上宣布,发布一款新模型 Microsoft-Decision-1。微软 Office of the CTO 软件工程副总裁 Achint Srivastava 同步在微软 Command Line 发了技术介绍。
它只做一件事:从你给定的固定选项里挑出最优解,并给每个选项一个概率分数。
选项可以是“是/否”、多选题、数值打分,也可以是一套评分标准,用来给 AI 的回复或智能体的动作打分。调用一次 API,返回结构化数据,软件可以直接拿去执行,不用再从文本里解析答案。
微软列的用途包括:路由分发、内容分类、优先级排序、结果验证、工作流控制、数据标注、搜索相关性、安全筛查,还有智能体动作管控。简单说,它是给智能体工作流当“裁判”和“分拣员”的。
多少钱,在哪用
现在可以在 Microsoft Foundry 和 OpenRouter 上调用。价格很便宜:输入每百万 token 0.042 美元,输出免费。
有两个限制。第一,它只接受纯文本输入,没有视觉能力。第二,微软没有开放模型权重,只能调 API 用。这两点不如 Cloudflare 的 Clef:Clef 带视觉编码器,权重还是 Apache 2.0 开源的。
微软公布的成绩
微软说,在 36 项基准、近 15 万道训练时没见过的题目上,Decision-1 的准确率(83.5%)排第一。速度上,微软称它比次快的竞品快 2.5 倍(另一份材料里写的是 4.5 倍,对比对象不同),比 GPT-6 Sol 快 35 倍。
微软还给了个内部例子。Xbox Research 团队用它给 1 万多条游戏反馈做分类,质量和 GPT-6 Sol 相当,速度快 14 倍以上,成本低约 200 倍。
稳定性方面,微软做了 8 种等价改写测试,比如改写选项描述、打乱选项顺序,平均只有 1.3% 的情况下决策会改变。安全测试做了 5250 次请求,覆盖有害内容、越狱和提示注入 11 项基准。
以上都是微软自测数据,目前还没有第三方验证。
有意思的背景
Decision-1 的基础模型是阿里的开源模型 Qwen3.5-9B,微软在它上面做后训练。微软同时表示,以后会换成自家的 MAI 系列和 OpenAI 的模型。
决策模型这个赛道,是 9 月中被创业公司 TypeSafe 的 Jev 带火的。随后 OpenAI 在 10 月初把 Decisions API 推向公开测试,Cloudflare 开源了 Clef 决策模型。微软是第四个入场的大玩家。
有个细节值得留意:微软的 36 项基准对比里,没有纳入 Cloudflare 的 Clef。所以“最快最准”的说法,只在它自己选的对比范围内成立。
对谁有用
如果你在搭智能体工作流,一个现成的省钱思路是:把决策环节(分类、路由、验证、打分)交给 Decision-1 这类小模型,生成环节留给大模型。微软的定价就是冲这个来的:输出免费,决策这种高频调用场景用起来不心疼。
当然,先在自己的任务上测一遍再说。基准数字是微软自己跑的。