资讯
OpenAI 一次公开 722 篇数学论文:未发布模型的解题成果,GitHub 开源
10 月 6 日,OpenAI 把内部一个未发布前沿模型解出的 722 篇数学手稿公开到 GitHub,Apache-2.0 协议开源,部分证明附 Lean 形式化验证。这是它九周内第三次发布数学成果,数学界反应两极:有人叫好,有人要求先看证据。
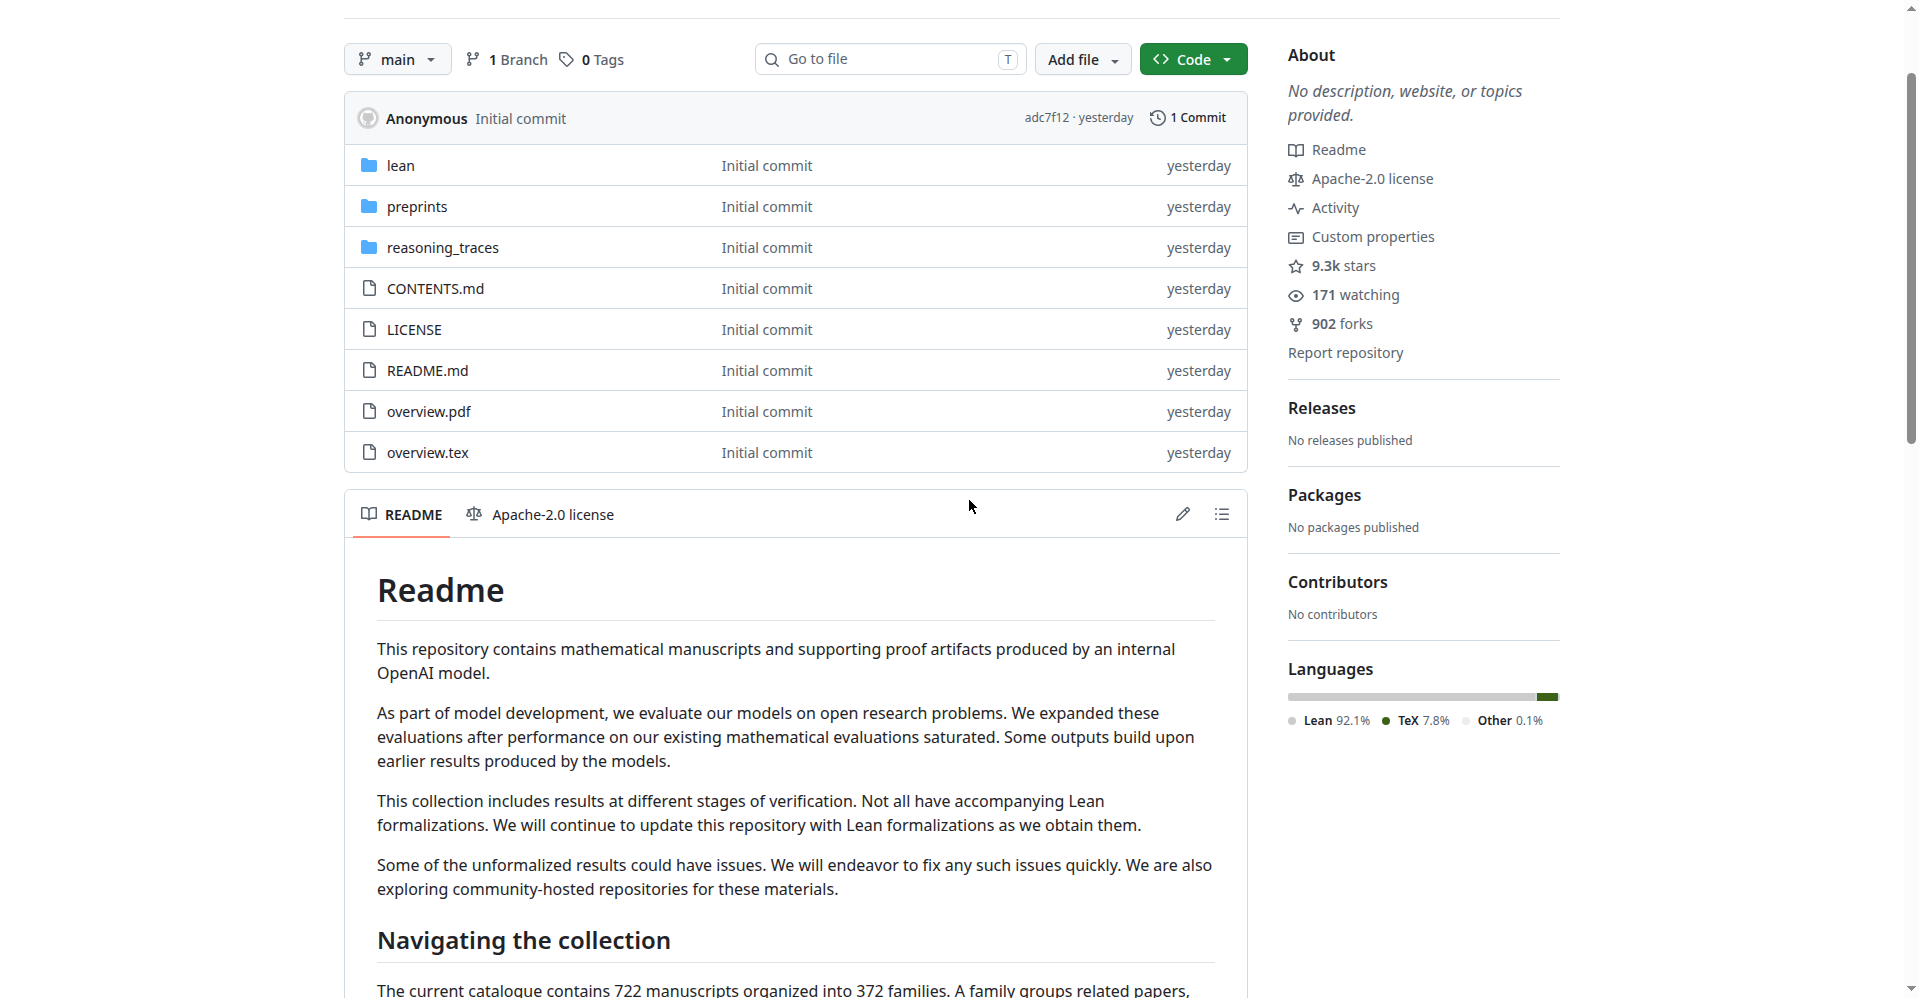
10 月 6 日,OpenAI 发布了一篇研究文章,一次性公开了 722 篇数学手稿。这些成果来自公司内部一个尚未发布的前沿模型,全部放在 GitHub 仓库 openai/math 里,Apache-2.0 协议开源,任何人都能下载验算。
722 篇,归成 372 个家族
722 篇手稿按主题归成 372 个“家族”。一个家族里可能包含主结果、配套论证、推论或替代证明,每个家族按数学分支分类。
每份手稿有自己的目录:PDF、源码、引用格式和构建说明。仓库里还有一个 Lean 形式化证明库,列出哪些证明已经过了机器校验。每份手稿目录里都带一段 BibTeX,方便引用。
OpenAI 说,模型一共被出了约 4000 道开放问题,筛掉不够重要的,剩下的整理成这 722 篇。每份成果平均消耗的算力,约等于 ChatGPT Pro 三小时的深度推理。
不是每篇都能机器验算
仓库的 README 自己提醒:不是所有手稿都有 Lean 形式化证明。Lean 是一种能让计算机逐条检查证明的语言,有它的证明基本可信;没有的还是 PDF,得靠人审。OpenAI 说,未形式化的结果可能有问题,发现了会修,修订会记成新版本,老版本保留可查。
10 篇手稿附带了模型推理过程的精简摘要,涉及 Mahler 猜想、NP 难问题、自旋玻璃、Vlasov-Maxwell 系统。另外有两个特殊成果走了别的路子:黎曼 zeta 函数在 Re(s) > 11/12 区域的零点分布,以及 CM 阿贝尔簇上的 Hodge 猜想证明。其中 zeta 那篇有人类参与润色,为了好读。
数学界:有人叫好,有人要证据
多伦多大学的数学家 Daniel Litt 觉得这是好事:既然有了答案,没理由让公司藏着。MIT 的 Andrew Sutherland 则要求先看证据再说。
Startup Fortune 的报道更直接:不少一线数学家的第一反应是警惕,而不是喝彩。一次扔 722 篇,人类同行评审根本审不过来。这正是 OpenAI 推 Lean 形式化的原因:让机器先挡掉一部分审查工作量。
此前也有过一次独立审计。arXiv 上有人复核了 OpenAI 8 月 1 日发布的那 10 个成果,抽查的几篇没发现实质性数学错误,但审查深度参差不齐。10 月这批还没人审完。
九周内的第三次
这次发布不是孤立的。8 月 1 日,OpenAI 公开了一个叫 Astra 的内部模型,拿出 10 个成果。有些问题十年没人动过,包括把球堆积界的纪录往前推了一步——上一次推进是 1978 年。
9 月 8 日,OpenAI 声称模型找到了 Navier-Stokes 方程的有限时间爆破解。这是克雷数学研究所七个千禧年难题之一,配了 166 页的手稿。后来 OpenAI 又说,在 Hodge 猜想上也有实质性进展,不过那次没给证明细节。
the-decoder 提到一个对比:这次 722 篇里,几乎每个成果都来自对单个 AI agent 的一次提问;而 Navier-Stokes 那次动用了 1 万个 agent 和数百万美元的算力。单次提问就能出成果,说明模型在数学上的“一次做对”能力在涨。
发布前先问了数学家
这次发布前,OpenAI 咨询了普林斯顿高等研究院的一个独立咨询组:“数学与人工智能咨询组”。这个组 9 月 29 日刚发布过一份负责任发布建议,收集了 600 多位数学家的反馈。
建议里有几条很具体:别拿高难数学题去测不公开的模型;如果提问者自己都还没理解结果,就公开模型名字、提示词、推理摘要和算力成本;别把数学成果当成模型的营销素材。
OpenAI 发言人回应说,公司认真对待这些指南,但不受其约束。实际公开的内容是:平均算力消耗、尝试的问题数量统计、10 份推理摘要。提示词没公开,模型名字也没公开。
对你意味着什么
对做研究的人来说,openai/math 是个现成的矿:722 篇带引用格式的手稿,一部分已经机器验算过,可以直接拿去审、去用、去挑错。
对 AI 行业来说,这次发布把“模型能不能做原创数学”从争论变成了可审计的材料。证据链是公开的,质疑也是公开的。接下来几个月,数学界能从这 722 篇里挑出多少真东西,比发布本身更说明问题。